@[TOC](内容预览 ≧∀≦ゞ
信息收集系列(六):路径爬取与目录爆破
前言
在信息收集的过程中,路径爬取(爬虫)与目录爆破是获取隐藏资源和潜在漏洞的两种核心方法。本篇将结合工具和实际经验,深入解析如何高效进行路径爬取与目录爆破,从而快速挖掘出隐藏漏洞。
路径爬取
路径爬取的目的是全面发现目标站点的所有可访问路径,包括隐藏的 API、测试页面、未公开的资源等。这个过程不仅能帮助测试人员识别隐藏的入口,还能为后续的漏洞测试提供数据支持。以下是几种常用的路径爬取工具及其使用方法。
Burp Suite Pro
Burp Suite Pro 是渗透测试中至关重要的工具,除了常见的代理抓包功能外,很多用户往往忽略了其强大的扫描和爬虫功能。
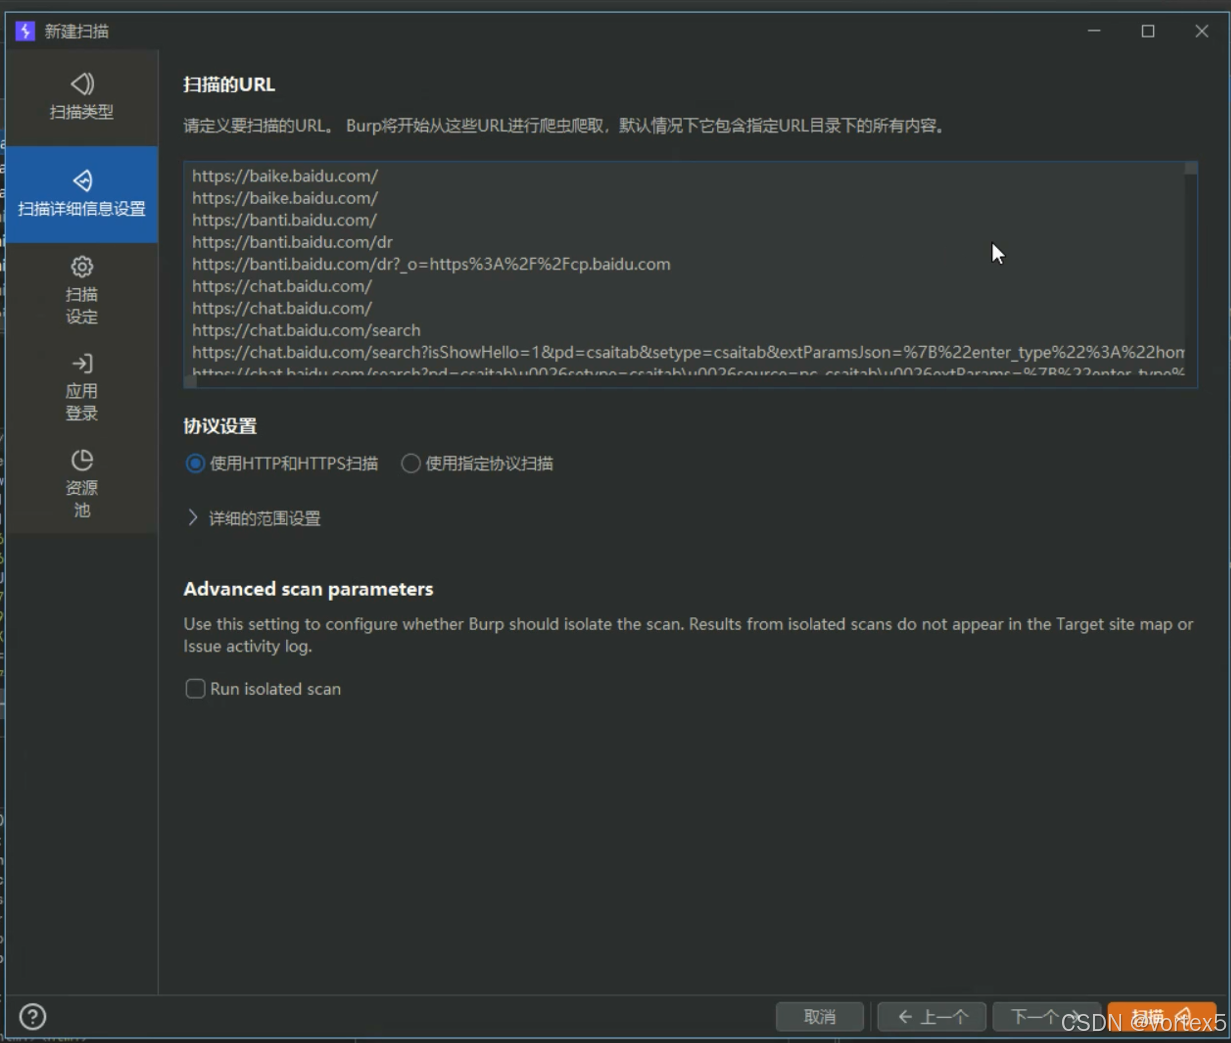
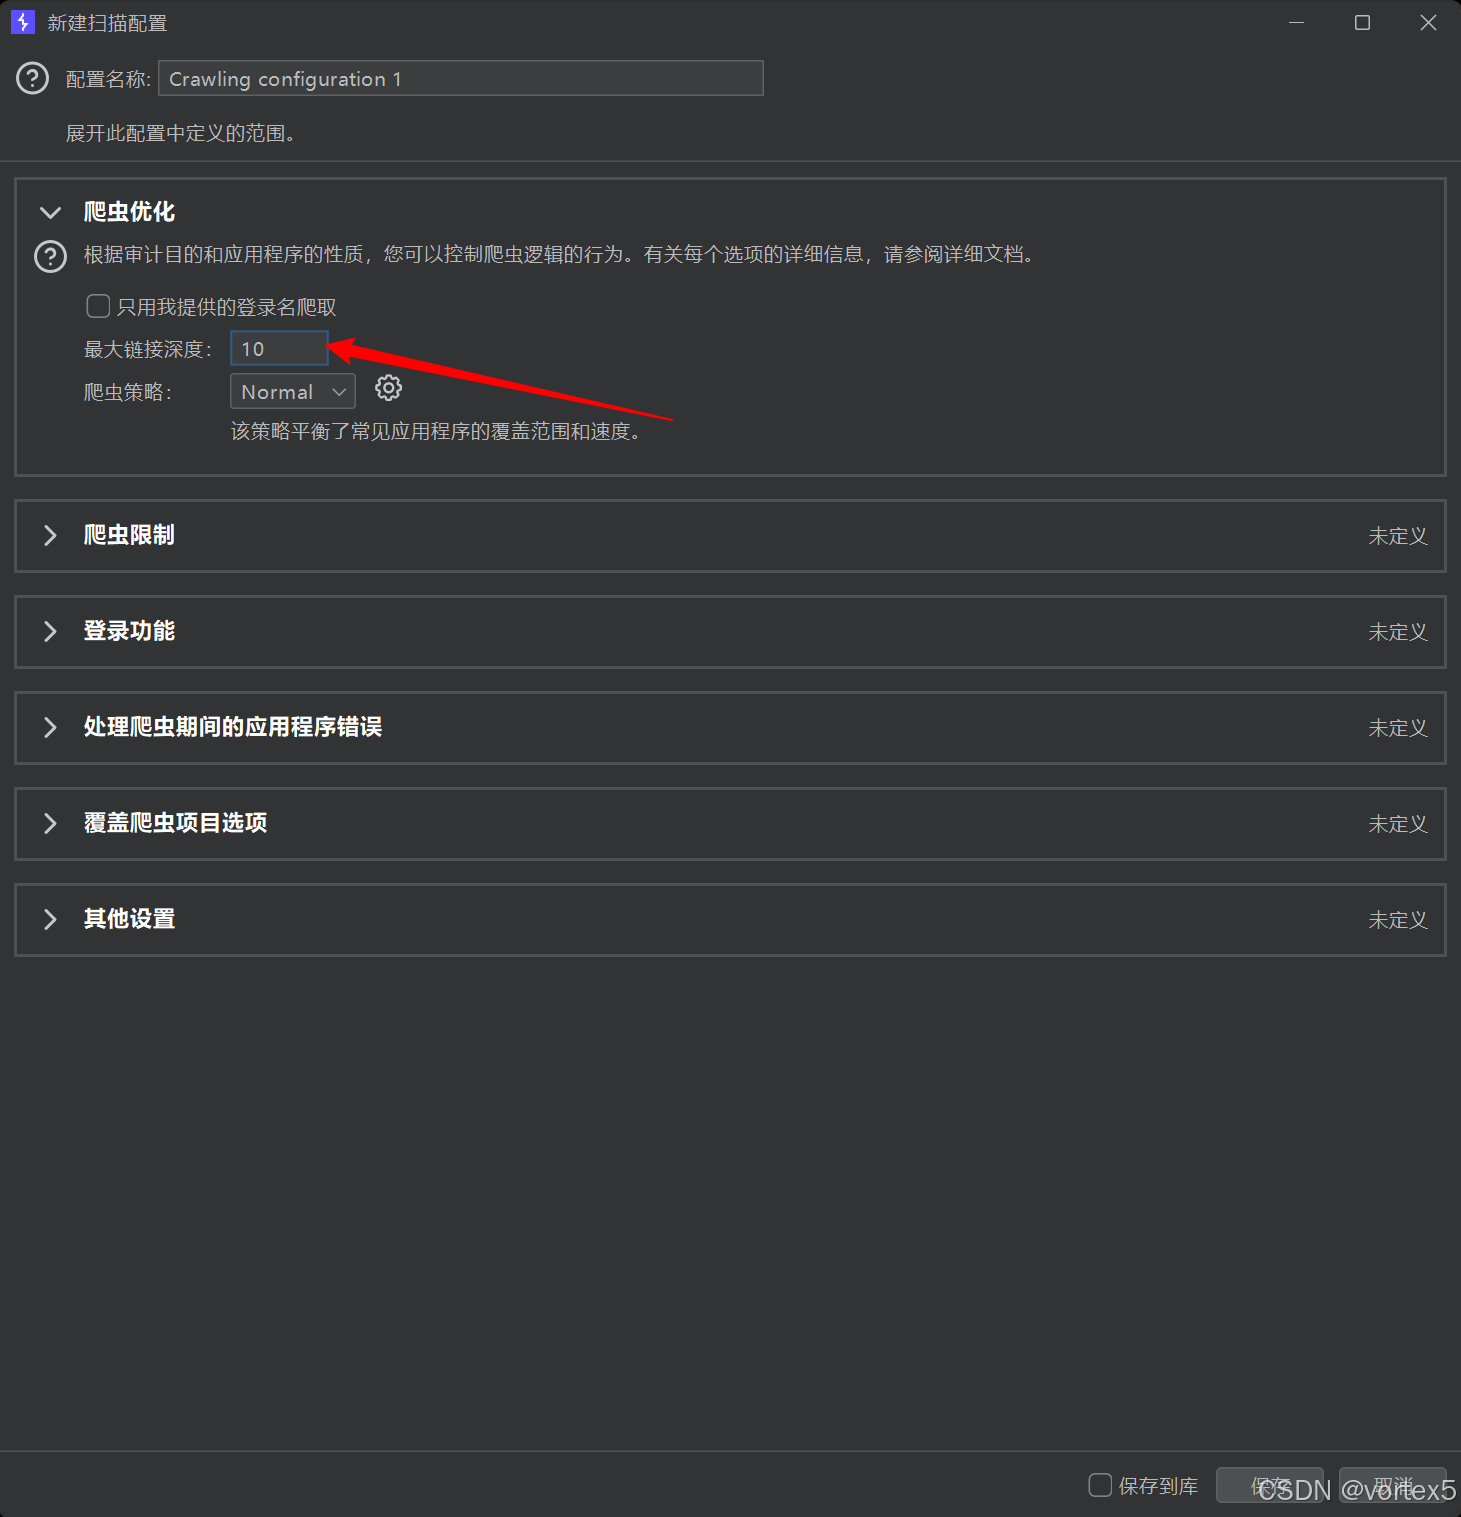
此外,利用好 Scope(范围)功能可以帮助你限定测试范围,将精力集中在目标网站,避免无关项的干扰。
- 注意事项:在首次启动 Burp 时,务必创建一个项目并保存你的数据。这样可以确保在后续测试过程中,无论是进行信息收集、功能探索还是漏洞挖掘,都能方便地访问历史记录进行对比与复查。
Katana
Katana 是一个轻量级的 Web 爬虫,专门用于快速发现站点路径,并且具有非常高的效率。其支持多个文件类型的快速扫描,尤其适合快速抓取站点的常见路径。
GitHub 地址:https://github.com/projectdiscovery/katana
cat subs_live.txt | katana -sc -kf robotstxt,sitemapxml -jc -c 50 > katana_out.txt- 参数解析:
-sc:启用子域扫描,能够帮助你发现隐藏的子域和路径。-kf:扫描关键文件类型,如robots.txt、sitemap.xml,这些文件常常包含了站点路径和资源指向。-jc:启用 JavaScript 文件解析,发现动态加载的 URL。-c 50:限制并发连接数为 50,避免过度占用资源。
实战建议:Katana 的并发扫描非常快速,但对于大站点或深度扫描时,建议降低并发连接数以避免服务器过载。
Hakrawler
Hakrawler 是一个简单且高效的 Go 语言编写的爬虫,专为收集网站的 URL 和 JavaScript 文件路径而设计。它的优点是速度快,配置简单,适用于快速爬取较小站点。
GitHub 地址:https://github.com/hakluke/hakrawler
使用实例:
cat subs_live.txt | hakrawler -subs > hakrawler_out.txt- 实战技巧:由于 Hakrawler 的输出可能会包含大量的冗余数据,建议通过管道过滤(如
grep或awk)对输出进行二次处理,提取关键信息。
优化建议:若目标站点较大,可以通过对 Hakrawler 的扫描结果进行 2-3 次迭代扫描,逐步过滤出有效路径。
Gospider
Gospider 是一个用 Go 语言编写的快速 Web 爬虫,支持多源数据获取,如从 Archive.org 和 VirusTotal 等资源中抓取已知 URL,非常适合在没有明确路径的情况下进行深度挖掘。
GitHub 地址:https://github.com/jaeles-project/gospider
使用实例:
gospider -S subs_live.txt -o gs_output -c 50 -d 2 --other-source --subs --sitemap --robots- 参数解析:
--other-source:启用外部数据源,如 Archive.org,帮助发现历史上的路径。-d 2:设置爬取深度为 2,进一步探索站点的子页面。--subs:扫描子域,帮助发现隐藏的子域路径。
注意事项:Gospider 在处理大站点时可能会消耗较多内存,建议按需分批次执行,避免资源消耗过高。
Gau (GetAllUrls)
Gau 是一款非常流行的工具,能够从多个开源平台(如 AlienVault、Wayback Machine、Common Crawl、URLScan)获取目标站点的已知 URL。这个工具特别适用于从外部数据源快速抓取大量的历史 URL。
GitHub 地址:https://github.com/lc/gau
使用实例:
cat subs_live.txt | gau > gau_out.txt-
实战技巧:由于 Gau 输出的 URL 数量庞大,其爬取的结果需要进行去重和清洗操作。可以使用
sort | uniq命令去除重复路径,并通过正则表达式筛选出关键信息。 -
附加建议:利用 Gau 提供的大量历史数据,结合路径爬取和漏洞扫描,可以大大提高发现潜在漏洞的速度。
Oxdork
Oxdork 是一个用于执行 Google Dork 查询的工具,帮助测试人员通过搜索引擎发现潜在的漏洞或未公开的资源。它的优势在于可以快速获取目标站点的隐藏信息,如未授权访问的页面。
GitHub 地址:https://github.com/rly0nheart/oxdork
使用实例:
oxdork "site:yahoo.com" -c 100- 注意事项:由于 Google 对搜索引擎爬虫的限制,运行 Oxdork 时需要设置代理,避免 IP 被封禁。使用云服务器或 VPN 配合运行效果最佳。
路径爬取的价值
路径爬取的核心作用是为渗透测试提供有效的入口点。正如一句话所说:“要想找到漏洞,首先得找到那个漏洞所在的路径。” 例如许多自动化工具在进行 XSS 漏洞挖掘时,通常会先通过爬虫抓取网站路径,再结合 fuzz 技术,对爬取的 URL 进行参数模糊测试,实现自动化批量挖洞。
但我们不能完全依赖爬虫,因为人人都会用自动化工具,如果仅仅依赖工具爬取的路径,往往会与他人重复,导致测试覆盖的局限性。
目录爆破
目录爆破是一种通过字典匹配的方式,尝试枚举出网站服务器上的静态路径和敏感文件。这是渗透测试中的一个关键环节,常常用于发现未授权的访问点、敏感数据或开发人员遗留的测试文件。下面是一些常用的目录爆破工具和实战技巧。
Feroxbuster
Feroxbuster 是一款高效的多线程目录爆破工具,支持快速枚举目标站点的目录和文件。
GitHub 地址:https://github.com/epi052/feroxbuster
使用示例:
feroxbuster -u https://promo.indrive.com/ -w paths.txt -t 20 --filter-status 404 -x html,php参数说明:
--url:指定目标 URL,工具将会枚举此网站的目录和文件。-w:指定字典文件(paths.txt),该文件包含了用于爆破的路径字典。-t:设置并发线程数,-t 20表示使用 20 个线程并行进行扫描。增加线程数能够提高扫描速度,但也可能对目标服务器产生较大负载。--filter-status:指定要排除的 HTTP 响应状态码。-x:指定要爆破的文件扩展名,多个扩展名之间用逗号分隔。
Dirsearch
Dirsearch 是另一款非常流行的目录爆破工具,它支持通过字典文件进行深度扫描,能够帮助渗透测试人员发现站点中的敏感路径。
GitHub 地址:https://github.com/maurosoria/dirsearch
使用示例:
python3 dirsearch.py -u https://target.com -e php,html,js,txt -t 2 -i 200,300-399参数说明:
-e: 指定要搜索的文件扩展名。-t: 指定同时运行的并发线程数。-i: 保留的响应状态码。
关键 :这里推荐适当整合一些师傅们发出来的路径字典到 /dirsearch-0.4.2/db/dicc.txt 中
字典选取
优质的字典是目录爆破成功的关键。选择合适的字典不仅能提高爆破的效率,还能帮助你准确地识别目标站点的隐藏目录和文件。以下是一些推荐的字典资源和分类建议,适用于不同类型的目录爆破任务。
以下是一些 GitHub 上常用且经过验证的热门字典资源,它们涵盖了各种类型的路径爆破场景,包括常见目录、文件扩展名等:
-
Assetnote Wordlists: https://wordlists.assetnote.io/
-
SecLists - Web Content: https://github.com/danielmiessler/SecLists/tree/master/Discovery/Web-Content
-
Orwagodfather WordList: https://github.com/orwagodfather/WordList
如果你对字典选择不熟悉,可以先尝试以下常见的字典,它们已经在多次渗透测试中验证过有效,适合不同的爆破场景:
-
403 绕过字典: https://github.com/danielmiessler/SecLists/blob/master/Fuzzing/403/403.md
-
Bo0oM Fuzz Dictionary (4k 量级): https://github.com/danielmiessler/SecLists/blob/master/Fuzzing/fuzz-Bo0oM.txt
-
Bo0oM Fuzz.txt (5k 量级): https://github.com/Bo0oM/fuzz.txt/blob/master/fuzz.txt
-
Orwagodfather Fuzz Dictionary (22k 量级): https://github.com/orwagodfather/WordList/blob/main/fuzz.txt
-
Hfuzz Dictionary (18w 量级): https://github.com/thehlopster/hfuzz/blob/master/hfuzz.txt
-
OneListForAll(多个量级): https://github.com/six2dez/OneListForAll
字典选择技巧
字典选择应根据目标站点的规模、攻击深度和测试时间进行合理配置。较小的字典适合快速扫描和初步探索,而大规模字典则适用于高强度的全面测试。
多级路径爆破建议
在进行多级路径爆破时,特别是在涉及较深路径结构时,建议使用小型字典,字典行数控制在 100~500 行 之间。这样做可以避免测试过程中出现大量无关路径的干扰,节省时间并提高效率。小字典通常包括以下内容:
- 常见的敏感文件(如
config.php、backup.zip等)。 - 常见的接口路径(如
/api/、/v1/、/actuator等)。
这种字典可以在短时间内提供较为准确的扫描结果,有助于快速定位潜在的敏感目录和资源。
总结
路径爬取与目录爆破是信息收集的基础工作,但不能完全依赖工具单独完成任务。在实际操作中,需要结合多种工具和方法,灵活调整策略。
原文 https://blog.csdn.net/2301_79518550/article/details/143984597