引言
在现代软件开发中,中文支持已经成为一个不可忽视的重要部分。然而,由于编码不一致、环境配置不当或程序处理不当,中文乱码问题时常困扰开发者。乱码不仅影响用户体验,还可能导致数据损坏或功能异常。本文将基于 Unicode 编码体系,结合实际案例,探讨中文乱码的成因、排查方法以及解决方案,帮助开发者系统性地解决中文乱码问题。
一、乱码问题的基本概念
1.1 什么是乱码
乱码是指在显示或处理文本时,字符无法正确解析,导致出现不可读的符号(如“��”或“??”)或不符合预期的字符。乱码的根本原因是编码与解码不匹配,即编码时使用的字符集与解码时使用的字符集不一致。
1.2 常见编码格式
- UTF-8: Unicode 的可变长度编码格式,支持全球几乎所有字符,是当前互联网标准编码。
- GBK: 针对简体中文设计的双字节编码,支持 GB2312 扩展字符集。
- UTF-16/UTF-32: Unicode 的固定长度编码,分别使用 2 字节或 4 字节表示字符。
- ISO-8859-1: 单字节编码,主要用于西欧语言,不支持中文。
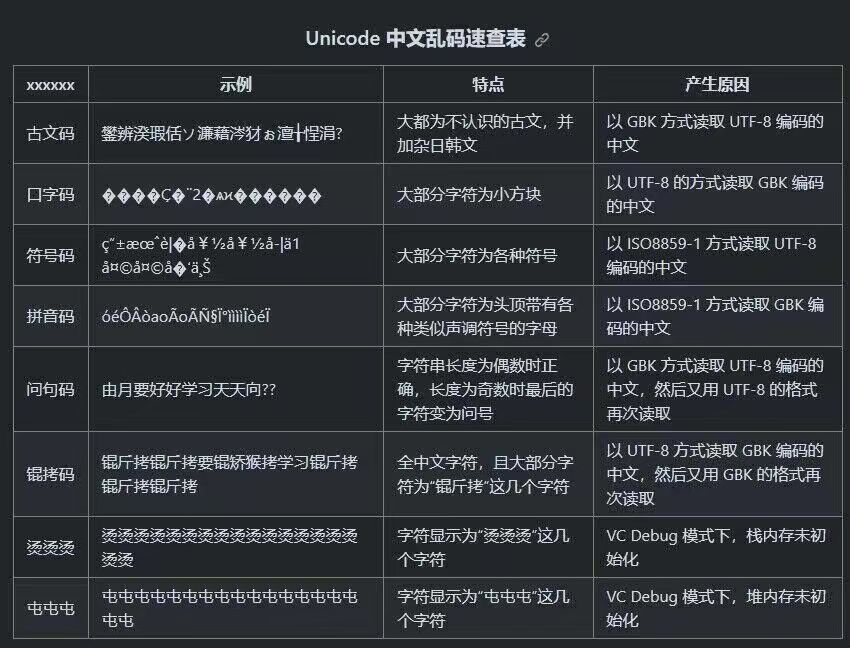
图片中列举了 UTF-8、GBK 等编码,以及对应的乱码表现(如“��”或“?”),这提示我们需要关注编码转换和环境配置。
1.3 乱码的成因
- 编码不一致: 例如,文件保存为 GBK,但程序按 UTF-8 解码。
- 环境配置错误: 操作系统、数据库或浏览器编码设置不匹配。
- 数据传输问题: 网络传输中编码转换丢失。
- 程序处理不当: 未正确指定字符集或使用错误的解码方法。
二、乱码排查方法
2.1 确定输入与输出编码
首先,检查数据的来源和目标环境的编码。例如,图片中的“UTF-8 编码 UTF-8 编码的中文”表明输入和输出应一致。如果输入是 GBK 编码的文件,程序却按 UTF-8 解码,就会出现“��”乱码。
排查步骤
- 查看文件编码: 使用工具如 Notepad++ 或
file命令检查文件编码。 - 检查程序设置: 确认代码或配置文件中指定的编码(如 Java 的
-Dfile.encoding或 Python 的encoding参数)。 - 验证输出环境: 浏览器、终端或数据库的默认编码是否与预期一致。
2.2 分析异常字符
乱码字符(如“��”)通常表示 Unicode 替换字符(U+FFFD),表明解码器无法识别字节序列。图片中“GBK 方式读取 UTF-8 编码的中文”导致的乱码,提示我们需要关注编码转换过程。
排查技巧
- 日志分析: 检查日志中是否记录了异常字符。
- 十六进制查看: 使用
hexdump或类似工具查看原始字节,判断是否为预期编码。 - 对比样本: 将乱码文本与正确文本对比,推测编码差异。
2.3 环境检查
- 操作系统: Windows 默认编码可能是 GBK,Linux 可能是 UTF-8。
- 数据库: MySQL 或 PostgreSQL 的字符集(如
utf8mb4或gbk)需与应用一致。 - 网页: HTML 文件的
<meta charset>标签需明确指定编码。
三、解决方案
3.1 统一编码标准
建议在项目中统一使用 UTF-8 作为标准编码,因为它支持多语言且是现代互联网的默认选择。
- 文件保存: 使用文本编辑器将所有源文件保存为 UTF-8。
- 程序配置: 在代码中显式指定编码,例如 Python 中的
open('file.txt', encoding='utf-8')。 - 数据库: 设置字符集为
utf8mb4,并确保连接字符串中指定charset=utf8mb4。
3.2 环境配置调整
- 操作系统: 在 Windows 上设置环境变量
set PYTHONIOENCODING=utf-8。 - 终端: 确保终端支持 UTF-8,例如 Linux 下
export LANG=en_US.UTF-8。 - 浏览器: 在 HTML 中添加
<meta charset="UTF-8">。
3.3 编码转换工具
当无法避免编码不一致时,可使用工具进行转换。
- Iconv:
iconv -f GBK -t UTF-8 input.txt -o output.txt - Python 脚本:
with open('input.txt', 'r', encoding='gbk') as f:
    text = f.read()
with open('output.txt', 'w', encoding='utf-8') as f:
    f.write(text)
3.4 调试与测试
- 单元测试: 编写测试用例,验证中文输入输出。
- 日志记录: 在关键点记录编码信息,便于排查。
- 工具使用: 使用 VS Code 或 VC Debug 工具,设置断点检查变量编码。
四、具体场景解决方案
4.1 网页中文乱码
- 问题: HTML 文件按 GBK 保存,浏览器按 UTF-8 解析。
- 解决: 修改
<meta>标签为<meta charset="GBK">,或将文件转为 UTF-8 并更新标签。
4.2 数据库中文乱码
- 问题: MySQL 表字符集为
latin1,插入 UTF-8 数据。 - 解决: 更改表字符集:
ALTER TABLE table_name CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
4.3 程序输出乱码
- 问题: Java 程序在 Windows 下输出“???”。
- 解决: 设置 JVM 参数
-Dfile.encoding=UTF-8。
五、总结
中文乱码问题看似复杂,但通过系统化的排查和统一编码标准,可以有效解决。UTF-8 作为现代开发的首选编码,能够满足多语言需求,而 GBK 等传统编码在特定场景下仍需兼容。本文结合图片中的示例,提供了从理论到实践的全面指南。开发者应在开发过程中注重编码一致性,并利用工具和测试确保高质量输出。
未来,随着 Unicode 的不断扩展,乱码问题可能会减少,但环境差异和遗留系统仍将是挑战。希望本文能为开发者提供参考,助力构建无乱码的中文应用。
原文 https://blog.csdn.net/2301_79518550/article/details/149442470